BLOG
「AIの出力は使う人次第」の、「使う人」を分解してみた
2026.10.27
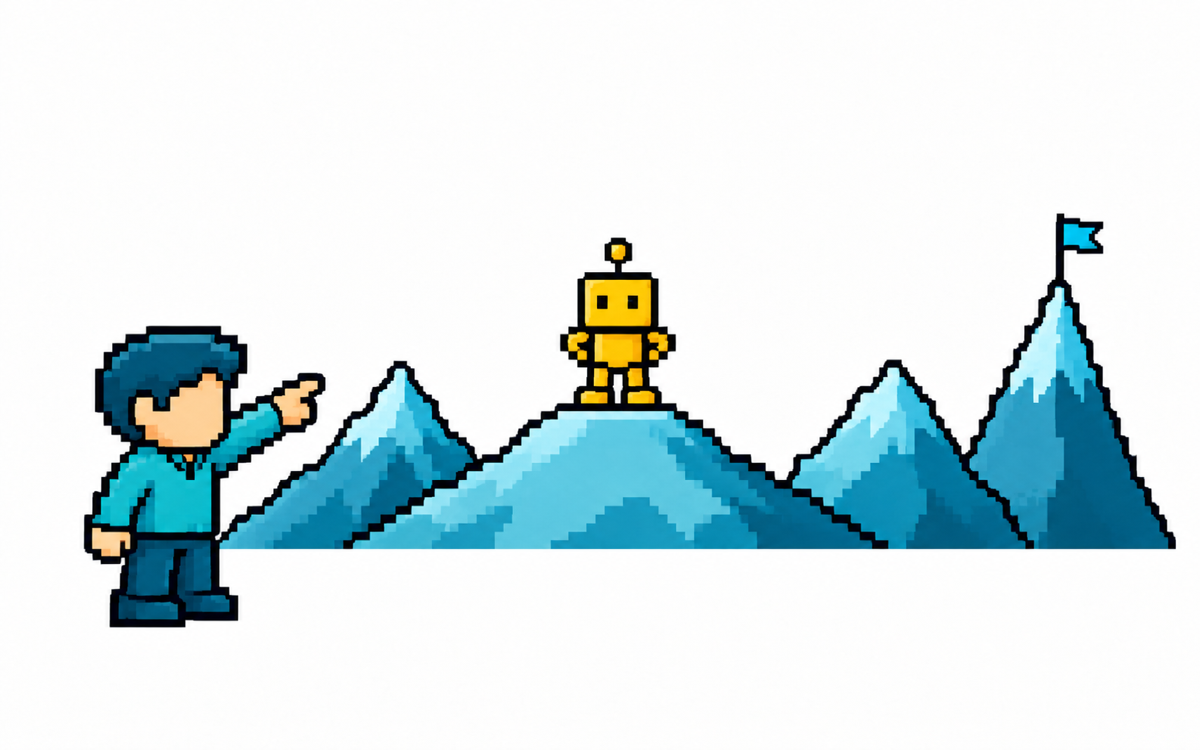
「AIの出力は、結局は使う人次第ですよ」。たぶん多くの人が同意すると思います。僕もそう言います。
でも「使う人次第」のまま止まると、何も説明していないのと同じです。なので、その中身を分解してみたい。要素を出しては潰し、言葉を入れ替えながら詰めていったら、最後はかなりシンプルな一行に落ちました。この記事はその記録です。
AIは「平均の山」を80点まで登る
今のAIは、何も考えずに頼んでも、80点くらいのものをサクッと作ってきます。センスの基礎部分は、もうかなり代替されています。
ただしその80点は、みんなの好みを平均した山の頂上です(この記事では、良さの度合いを山の高さに例えます。山は一つではないのですが、それは後で)。誰にとっても大きく間違っていないけれど、誰のためのものでもない。AIが書いた文章が「AI臭い」のはこれが理由で、特定の誰かではなく平均的な読み手に向けて、全部を均等に説明してしまう。
デザインで言えば、何にでもデフォルト値のドロップシャドウをかけて、パラメーターを一切いじっていない状態に近いです。デフォルト値は「どこに置いても大きく外さない値」として設計されています。裏返すと、どこにも特に合っていない。
プロはそこから、光源に合わせて角度を変え、画面全体で距離とぼかしを揃え、そして「ここに影はいらない」と外します。差がつくのは、いつもこっち側です。
人がやる操作は「ガード」と「ガイド」だけ
突き詰めると、使う人がAIに対して実際にやっている操作は、二つしかないと思っています。
- ガード: AIに推論させない部分。ルールとして外から固定する。「外部リンクは別タブで開く」「この色は使わない」「営業時間と料金は資料に書いてある値だけを使う」
- ガイド: AIに推論させる部分。そこから広げてもらうための種を渡す。「読み手は初めて来る人で、スマホで読む」「職人の手仕事の質感に寄せたい」
この二つは強弱の違いではなく、効き方が違います。ガードは考えさせずに守らせるルールで、ガイドは考えてもらうための材料です。
ハルシネーション(AIがもっともらしい作り話をするやつ)も、この二つで説明できます。料金や日付のように、本来ガードで固定すべき所をゆるく任せると、AIは穴を埋めるために作り話をする。逆に、表現や発想のように、ガイドで十分な所をガードで縛ると、出力が窮屈になる。要は、どこまでを固定してどこからを任せるか、その線の引き間違いです。
「何が欲しいかをはっきりさせろ」とよく言われますが、はっきりしていればいいわけでもありません。自分が分かっている以上に具体的に指定すると、それ自体がハルシネーションの素になります。指定の中の、自分でも確かめていない部分まで、AIは正しい前提として辻褄を合わせにいくからです。
ガードの言葉は閉じ、ガイドの言葉は開く
ルールを書くこと自体には、あまり工夫の余地がありません。差がつくのは、自分の中の「なんか違う」を言葉にできるかどうか。つまり言語化力です。
しかも同じ言語化でも、向きが逆になります。ガードの言葉は、誤読されないように連想を閉じる。ガイドの言葉は、類推が広がるように連想を開く。
ガイドが効く理由は、LLM(ChatGPT や Claude の中身の言語モデル)の仕組みにあります。LLM は、入力の中のどの言葉にどれだけ注目するかで出力が決まります(attention と呼ばれる仕組みです)。この感覚があると、一つの言葉が周辺の語彙を引き連れてくることが分かる。だから専門用語を一つ入れるだけで、出てくる言葉の傾向ごと専門家寄りに動きます。仕組みを意識している人は、知らない分野でも「まず語彙を集めよう」と動けるので、追いつく速さが違う。
センスの正体は「地形」の感覚
ガードとガイドをどこに置くかを決める前に、そもそも良いか悪いかが分からないと話になりません。いわゆるセンスです。センスそのものは分解しにくいのですが、イメージとしては「試行回数に裏付けされた、頂上まであとどれくらいか、の感覚」に近いと思っています。
ただし、頂上は一つではありません。良いものは複数あって、それぞれに最高点がある。山がいくつもある地形で、山ごとに標高が決まっているイメージです(遺伝的アルゴリズムを知っている人なら、適応度地形そのものです)。
この地形で見ると、ガードとガイドの役割もはっきりします。ガードで探す範囲を区切り、ガイドで探し始める場所を渡す。AIが候補を出し、人がどれを残すか決める。それを試行の回数だけ繰り返す。AIを使う人は、どこを探すかを決める設計者であり、同時に、何を残すかを決める側でもあります。
地形は「誰のために作るか」で決まる
アートでないなら、作るという行為は基本的に他人のためです。だから標高を決めているのは自分ではなく、受け取る人のほうになる。
ここで類推が必要になります。受け取る人の地形を推定して、どの山を目指すかを決める。そしてAIがこちらの言葉をどう読むかを推定して、その山に向かわせる。対象は違っても、どちらも「他者の評価関数(相手が何を良いとするか)を推定する」という同じ動作です。
頭が良くて親切な人が、知識のない相手にも伝わるように話せるのは、この類推が上手いからだと思っています。
目利きとセンスを分けるのは再現性
センスがある人とは、自分の地形で色々試して、それを分解できていて、他人のために再構築できる人だと思います。
- 目利き: 良し悪しが分かる。消費者でも持てる
- センス: 試して、分解して、他人向けに組み直せる。再現性がある
だから「消費者のセンスが良い」は、あり得ません。標高は感じられても、なぜ高いのかを分解できないので、同じ山にもう一度登れないからです。
AIが80点を出してくれる今、人間に残る価値は平均からの差分になります。平均の地形と、目の前の相手の地形はどこが違うか。そして80点から先、その山固有の頂上付近をどう登るか。
怖いのは、差分が見えない人には80点と95点の区別がつかないことです。80点で満足して止まり、本人は「AIでちゃんと作れている」と感じている。
「80点と100点の違いが分かる」を4段に割る
雑に言えば、AIを使う力は「80点と100点の違いが分かること」くらいのものです。ただ中身はもう少し複雑で、認知のレベルで割るとこうなります。
- 知覚: 何か違う、と感じる。標高を感じる段
- 弁別: どこが違うかを特定できる。分解の段
- 概念化: なぜ違うかを言葉にできる。言語化の段
- 転用: 別の相手、別の案件でも再現できる。類推して再構築する段
番号が小さい段ほど持っている人が多い。消費者は知覚まで、目利きは弁別まで、センスのある作り手は転用まで行けます。
知覚の段は、人間側の attention、つまりどこに目が行くか、と言ってもいいです。作ったことがある人は、どこをいじると全体が変わるかを手で知っているので、見るべき所に自然と目が行く。経験値とは、何を見てきたかで決まる注目の癖で、LLM でいう学習済みの重み(学習で決まった、何に反応するかの設定)に当たります。
「よくあるダメ」を言語化するのが効くのも、この段で説明がつきます。みんなが通る道を名指しされると、知覚しかできなかった人が一気に弁別の段に上がれる。
結論。変数は人ではなく「言語化された良さ」
ここまでを一行にすると、こうなります。
AI出力の質 = AIの平均 + 言語化された「誰かにとっての良さ」
試行して地形を知る。分解して、なぜ良いかを掴む。類推して、相手の地形に写し替える。言語化して、ガードとガイドにする。ここまで出てきた要素は、全部この右側の項をどう作るかの話でした。
そして決定的なのは、この項は言語化された時点で人から切り離せることです。頭の中にあるうちは「使う人次第」ですが、言葉になれば他の人も、ツールも、同じ差分を持ち込める。
いい例が、Anthropic が Claude 向けに公開している frontend-design というスキルです。クリーム背景にテラコッタのアクセント、全部同じ角丸カードに同じ薄い影など、AIが収束しがちなパターンを具体的に名指ししている。さらに、計画を立てたら似た依頼でも同じ所に着地しないかを自分で確かめろ、と平均からの距離を測らせている。良さを書くより、平均を書いて、そこから離れる手順を渡している。
だから「AIの出力は使う人次第」を正確に言い直すと、こうなります。使う人が持ち込める、言語化された良さの量次第です。